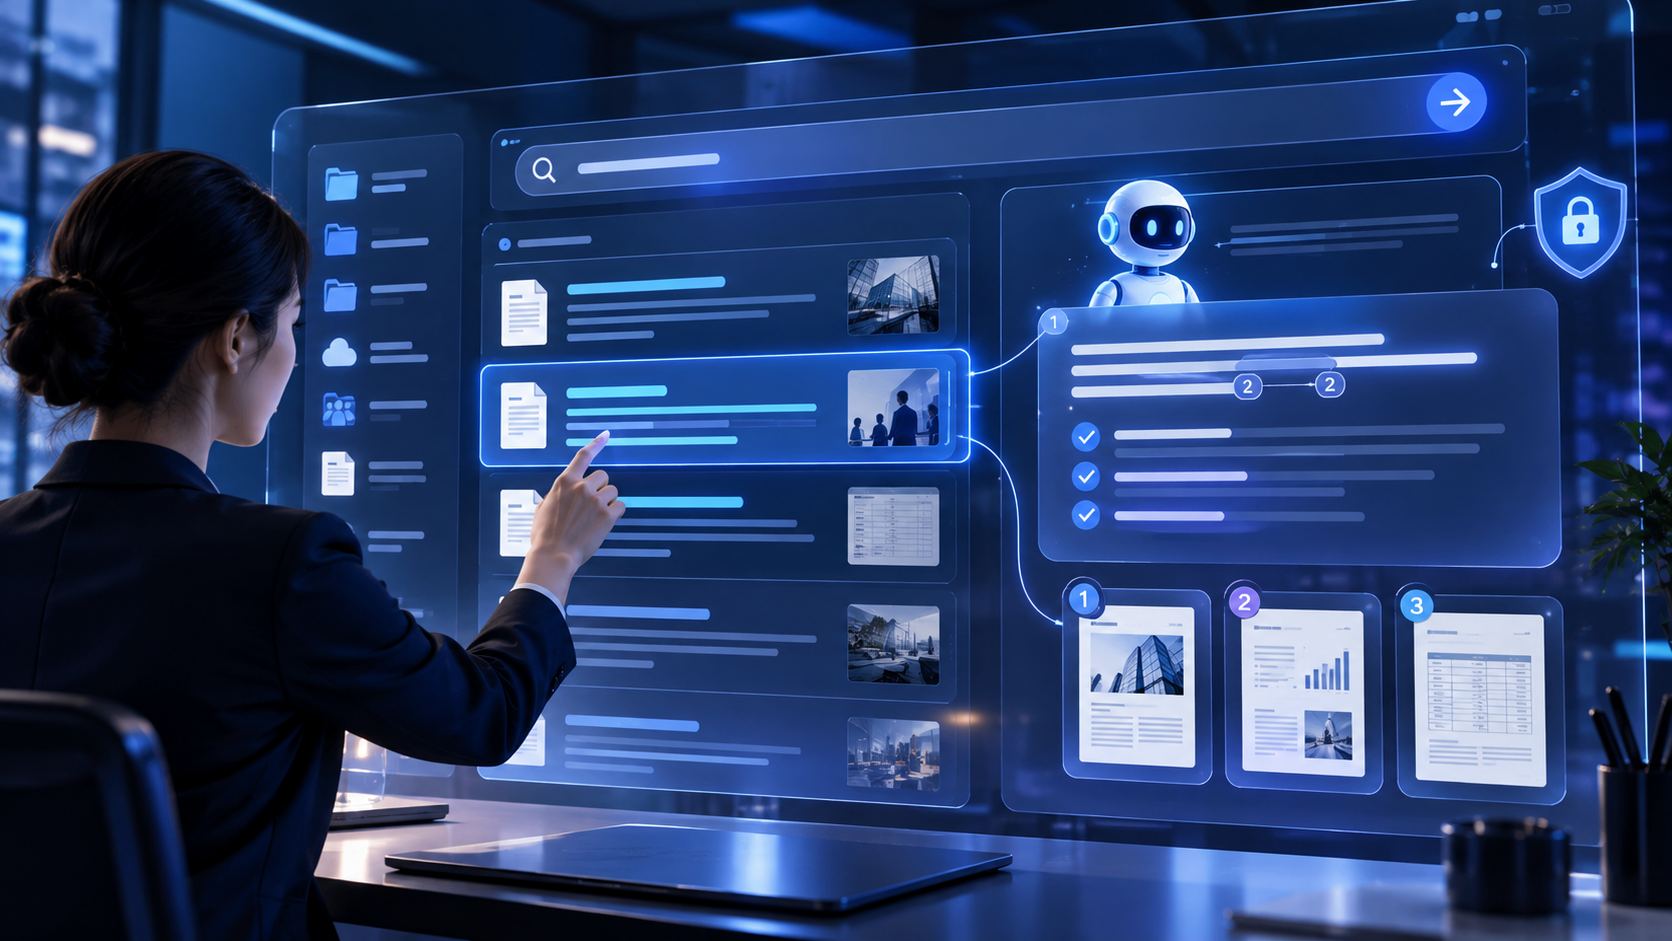
นิยามของคำตอบที่ดี
คำตอบที่ดีต้องตอบสามอย่างพร้อมกัน: สรุปอะไร, สรุปจากเอกสารไหนและหน้าใด, และผู้ถามมีสิทธิ์เห็นเอกสารนั้นจริงหรือไม่การค้นแบบ keyword เหมาะเมื่อผู้ใช้รู้คำที่อยู่ในเอกสาร แต่คำถามทางธุรกิจมักเป็นภาษาธรรมชาติ เช่น สัญญานี้ต่ออายุเมื่อไร หรือใบแจ้งหนี้ที่ยังไม่ผ่านการอนุมัติมีรายการใดบ้าง
RAG ช่วยค้นบริบทจากคลังเอกสารก่อนให้ AI สร้างคำตอบ แต่การทำให้ RAG ใช้จริงในองค์กรต้องจัดการ ingestion, metadata, chunking, version, access control, citation และการหยุดตอบเมื่อหลักฐานไม่พอ
Pipeline ตั้งแต่เอกสารเข้าไปจนถึงคำตอบ
เริ่มจากเก็บไฟล์และ metadata, OCR เอกสารสแกน, แยกส่วนเนื้อหาที่ค้นได้, สร้างดัชนีแบบ keyword และ semantic, กรองสิทธิ์, ดึงหลักฐานที่เกี่ยวข้อง แล้วจึงส่งบริบทให้ AI สรุป
การเรียงลำดับสำคัญมาก ถ้าสร้างคำตอบก่อนตรวจสิทธิ์ ผู้ใช้สามารถเห็นข้อมูลที่ตนไม่มีสิทธิ์ได้ แม้ระบบจะไม่ได้แสดงไฟล์ต้นฉบับโดยตรง
ใช้ hybrid search ไม่ใช่หวังพึ่ง vector อย่างเดียว
คำค้นบางชนิดต้องตรงตัว เช่น เลขที่สัญญา เลขผู้เสียภาษี หรือรหัสลูกค้า ส่วนคำถามเชิงความหมายต้องใช้ semantic retrieval การผสม keyword, metadata filter และ vector search ช่วยให้ทั้งแม่นและยืดหยุ่น
ควรเก็บ title, source URL, file name, page, section, effective date และ version ไว้กับแต่ละชิ้นข้อมูล เพราะ metadata เหล่านี้ช่วยจัดอันดับผลและทำ citation ที่ผู้ใช้ตรวจสอบได้
- ใช้ exact match กับเลขที่และรหัสสำคัญ
- ใช้ semantic search กับคำถามเชิงความหมาย
- กรองตามประเภท เอกสาร วันที่ และสถานะก่อน rerank
- จัดการ version และเอกสารหมดอายุไม่ให้ปนกับฉบับปัจจุบัน
Permission trimming ต้องเกิดก่อน retrieval
สิทธิ์ของ AI ควรสืบทอดจากสิทธิ์ของ DMS ผู้ใช้ที่เห็น matter หนึ่งไม่ได้แปลว่าจะค้นทุก matter ได้ และผู้ใช้ที่เปิดไฟล์ได้อย่างเดียวอาจไม่มีสิทธิ์ดาวน์โหลดหรือแชร์
ทดสอบด้วยบัญชีหลายบทบาทและเอกสารที่มีสิทธิ์ต่างกัน รวมถึงกรณีผู้ใช้ถามตรง ๆ ให้เปิดเผยเอกสารลับ ระบบควรตอบว่าไม่มีข้อมูลที่เข้าถึงได้ ไม่ใช่บอกว่ามีเอกสารแต่ไม่แสดงรายละเอียด
- กรอง document-level ACL ก่อนดึงเข้าผลค้น
- แยกสิทธิ์ดู ค้น ดาวน์โหลด และแชร์
- บันทึก user, query, sources และ model ที่ใช้
- ทดสอบ prompt injection และการถามข้ามทีม
Citation, freshness และการยอมรับว่าไม่พบข้อมูล
คำตอบที่ไม่มีที่มาไม่เหมาะกับนโยบาย สัญญา การเงิน หรือการตัดสินใจที่ตรวจสอบภายหลัง ผู้ใช้ควรเปิดไปยังไฟล์และหน้าที่ถูกอ้างได้ พร้อมเห็นวันที่และ version ของแหล่งข้อมูล
ตั้งกติกาให้ AI ตอบว่าไม่พบหลักฐานเมื่อ retrieval score ต่ำหรือเอกสารขัดแย้งกัน แล้วส่งต่อให้เจ้าของข้อมูลตรวจ การมี feedback และการวัด answer groundedness สำคัญกว่าการทำให้แชตดูตอบได้ทุกคำถาม
เช็กลิสต์ก่อนเริ่มใช้งาน
- เอกสารสแกนถูก OCR และตรวจคุณภาพ
- metadata มีชื่อไฟล์ หน้า version และวันที่มีผล
- ค้นแบบ hybrid และกรองสิทธิ์ก่อน retrieval
- คำตอบมี citation เปิดกลับไปดูต้นฉบับได้
- มีนโยบายเอกสารหมดอายุและ re-index
- เก็บ log และมีช่องทาง feedback
คำถามที่พบบ่อย
RAG ทำให้ AI ไม่หลอนเลยไหม
ไม่ทำให้เป็นศูนย์ แต่ลดความเสี่ยงได้เมื่อ retrieval มีคุณภาพ มี citation และมีกติกาให้หยุดตอบเมื่อหลักฐานไม่พอ
ทำไมต้องเก็บ page และ file name ในดัชนี
เพื่อให้ผู้ใช้ตรวจคำตอบกับเอกสารต้นฉบับได้ และช่วยวัดว่าระบบดึงหลักฐานมาถูกส่วนหรือไม่
เอกสารใหม่จะถูกค้นได้ทันทีไหม
ขึ้นกับรอบ ingestion และ indexing ควรกำหนด SLA การอัปเดต รวมถึงวิธีจัดการเอกสารฉบับเก่าและฉบับที่ถูกยกเลิก
อ่านต่อจากแหล่งอ้างอิง: Microsoft: RAG and citations · Microsoft: document-level access control · AWS: secure RAG access